Wyszukiwarka. Użyj ich, aby znaleźć przepisy, debugować kod lub dowiedzieć się, dlaczego Wi-Fi jest wolne. Ale kiedy wpiszesz zapytanie w Google, Bing lub innej dużej wyszukiwarce, nie szukasz „Internetu”. Szukasz sieci WWW. To rozróżnienie jest ważne, ponieważ Internet jest infrastrukturą. Sieć jest warstwą treści znajdującą się na niej.
Zanim w latach 90. dominował Internet, wyszukiwanie informacji w Internecie było uciążliwe. Programy takie jak Gopher i Archie indeksowały pliki na serwerach. Z pewnością skrócili czas wyszukiwania. Ale trzeba było dokładnie wiedzieć, czego szukasz i móc poruszać się po wczesnych, nieporęcznych interfejsach. Pod koniec lat 80., jeśli chciałeś uzyskać prawdziwą wartość z wyszukiwania online, musiałeś opanować Gophera, Archiego lub Veronicę. Większość ludzi tego nie zrobiła. Chcieli po prostu kliknąć i zobaczyć wyniki.
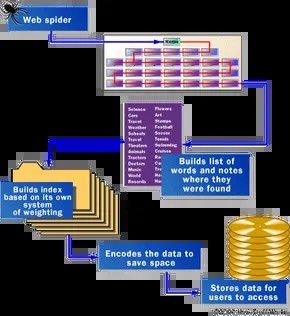
Obecnie uwaga skupia się niemal wyłącznie na Internecie. Aby tak się stało, wyszukiwarki korzystają ze specjalistycznego oprogramowania robotów. Nazywamy je pająkami.
Jak działa indeksowanie stron internetowych
Kiedy pająki przeszukują sieć i tworzą listę słów, proces ten technicznie nazywa się przeszukiwaniem sieci. Nazwa opiera się w dużej mierze na metaforach pająków, ponieważ konwencje nazewnictwa branży technologicznej przedkładają nowość nad przejrzystość.
Skala jest trudna do zrozumienia. Istnieją setki milionów stron. Pająki nie potrafią przeczytać wszystkiego na raz. Muszą od czegoś zacząć.
Zwykle zaczyna się od najpopularniejszych zasobów. Punktem wyjścia może być lista popularnych serwerów i stron o dużym ruchu. Pająk przechodzi na stronę główną, indeksuje słowa i podąża za wszystkimi znalezionymi linkami. Stamtąd rozprzestrzenia się dalej. Porusza się poziomo przez najczęściej połączone i najczęściej używane części sieci. To jest efekt fali. Jedna popularna strona prowadzi do innej strony, która prowadzi do następnej. Pająki nie potrzebują kart. Budują własną ścieżkę, korzystając z hiperłączy.
Wczesny silnik Google: szybkość jako kluczowa cecha
Aby zrozumieć współczesne roboty, musimy zrozumieć, jak giganci rozpoczęli swoją działalność. Google zaczynało jako projekt akademicki. Sergey Brin i Larry Page chcieli czegoś więcej niż tylko wyszukiwarki. Chcieli szybkiego systemu.
W swoim przełomowym artykule zaprezentowali wczesny system zaprojektowany z myślą o czystej prędkości. Wystrzelili więcej niż jednego pająka. Uruchomili kilka. Zwykle trzy. Każdy pająk może jednocześnie utrzymywać około 300 otwartych połączeń ze stronami internetowymi.
Kiedy te cztery pająki osiągnęły szczytowe obciążenie, system przeszukiwał ponad 100 stron na sekundę. To nie tylko szybkie. To jest agresywne. Generuje około 600 KB danych na sekundę.
Szybkość nie jest za darmo. Potrzebna infrastruktura. Wczesna konfiguracja Google miała dedykowany serwer do udostępniania adresów URL pająkom. Dlaczego? Ponieważ standardowy serwer DNS usługodawcy internetowego z opóźnieniem tłumaczy nazwę na adres IP. Podczas indeksowania milionów stron sumuje się nawet kilka milisekund opóźnienia. Google stworzył własny DNS, aby ominąć to wąskie gardło.
Co naprawdę widzą pająki?
Kiedy pająk Google odwiedza stronę HTML, nie „czyta” jej tak, jak robi to człowiek. Analizuje konstrukcję. Zauważa dwie istotne rzeczy.
- Słowa na stronie.
- Gdzie znajdują się te słowa.
Lokalizacja określa wagę. Słowa w tytule, podtytule i metatagach są szczególnie ważne w przypadku zapytań wyszukiwanych przez użytkowników. Pająk usuwa również „słowa stop”, takie jak „a”, „an” i „the”. Chociaż są powszechne, rzadko są przydatne do odróżnienia jednego dokumentu od drugiego.
Nie wszystkie pająki przestrzegają tych zasad.
Niektóre systemy, takie jak Lycos, próbują zoptymalizować szybkość i wydajność, koncentrując się tylko na najważniejszym tekście. Śledzą nagłówki, podtytuły, linki i słowa w pierwszych 20 wierszach treści. Szczególną uwagę zwracamy także na najczęściej używane słowo na stronie 100. Jest to podejście heurystyczne. Sugeruje, że najważniejszy jest początek i struktura.
AltaVista poszła w odwrotną stronę. Indeksuje każde słowo. W tym „a”, „an” i „the”. Logika jest tutaj doskonała. Gdy użytkownik szuka frazy zawierającej słowo stop, AltaVista może je wykryć. To podejście wymaga większej przestrzeni dyskowej i mocy obliczeniowej, ale jego celem jest kompletność, a nie szybkość.
Dlaczego wyniki wyszukiwania są różne?
Ta różnica w strategii wyjaśnia, dlaczego różne wyszukiwarki zwracają różne wyniki dla tego samego zapytania. Nie chodzi tylko o to, kto ma największy indeks. Ważniejsze jest to, co zdecydujesz się zaindeksować i jak ocenisz trafność.
Niektóre pająki wolą widoczny tekst. Inni eksplorują niewidoczne metadane. Niektórzy ludzie ignorują słowa bezpieczeństwa, aby zaoszczędzić miejsce. Inni zapisują je, aby rejestrować dokładne dopasowania fraz.
Walka pomiędzy szybkością a integralnością danych jeszcze się nie skończyła. Po prostu ewoluowała. Nowoczesne wyszukiwarki wykorzystują podejście hybrydowe, wykorzystując uczenie maszynowe do odgadnięcia, które słowa są ważne, zanim jeszcze naciśniesz Enter. Jednak podstawowy mechanizm pozostaje ten sam. Pająk spada (krzyży). Skorzystaj z linku. Tworzy listę. Otrzymujesz odpowiedź.
Obecnie sieć jest nadal zbyt duża, aby można ją było objąć w całości. Pająk nadal pracuje. Znajdują nowe strony szybciej, niż my jesteśmy w stanie je utworzyć.