



Пошукова система. Використовуйте їх, щоб знайти рецепти, налагоджувати код або з’ясовувати, чому Wi-Fi працює повільно. Але коли ви вводите запит у Google, Bing або будь-який інший великий пошуковий движок, ви шукаєте не Інтернет. Ви шукаєте Всесвітню павутину (World Wide Web). Ця відмінність є важливою, тому що Інтернет — це інфраструктура. Веб – це шар контенту, розташований над нею.
До того, як Інтернет захопив домінування в 90-х роках, пошук інформації в мережі був болісним. Такі програми, як Gopher та Archie, індексували файли на серверах. Вони, безперечно, скорочували час пошуку. Але вам потрібно було точно знати, що ви шукаєте і вміти орієнтуватися в ранніх, громіздких інтерфейсах. Наприкінці 1980-х років, якщо ви хотіли отримати реальну користь від онлайн-пошуку, вам доводилося освоювати Gopher, Archie або Veronica. Більшість людей цього не робили. Вони просто хотіли натиснути та побачити результати.
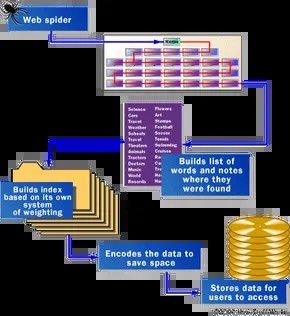
Сьогодні фокус майже винятково зміщений на веб-сторінки. Щоб це сталося, пошукові системи використовують спеціалізоване програмне забезпечення-роботів. Ми називаємо їх павуками (spiders).
Як працює індексація веб-сторінок
Коли павуки обходять веб і створюють список слів, цей процес називається веб-краулінгом (web crawling). Ця назва сильно спирається на метафори, пов’язані з павуками, оскільки угоди про імена в технологічній галузі надають перевагу новизні, а не ясності.
Масштаби важко зрозуміти. Існують сотні мільйонів сторінок. Павуки не можуть прочитати все одразу. Їм треба звідкись розпочати.
Зазвичай це починається з найпопулярніших ресурсів. Список популярних серверів та сторінок з великим трафіком може бути відправною точкою. Павук заходить на головний сайт, індексує слова і слідує за всіма знайденими посиланнями. Звідти поширюється далі. Він переміщається горизонталлю через найбільш пов’язані і найбільш використовувані частини мережі. Це ефект брижі. Одна популярна сторінка посилається на іншу сторінку, а та – на наступну. Павукам не потрібні карти. Вони будують свій власний шлях, слідуючи гіперпосиланням.
Ранній двигун Google: швидкість як ключова особливість
Щоб зрозуміти сучасних краулерів, нам потрібно зрозуміти, як гіганти розпочинали свій шлях. Google розпочинався як академічний проект. Сергій Брін та Ларрі Пейдж хотіли не просто пошукову систему. Вони хотіли швидкої системи.
У своїй основній статті вони подали ранню систему, розроблену для чистої швидкості. Вони запускали не одного павука. Вони запускали кілька. Зазвичай три. Кожен павук може одночасно підтримувати близько 300 відкритих підключень до веб-сторінок.
Коли ці чотири павуки досягли пікового навантаження, система обходила понад 100 сторінок за секунду. Це не просто швидко. Це агресивно. Вона генерує близько 600 КБ даних за секунду.
Швидкість не дається задарма. Потрібна інфраструктура. Раннє налаштування Google мала спеціальний сервер для подачі URL-адрес павукам. Чому? Тому що DNS-сервер стандартного інтернет-провайдера перетворює ім’я на IP-адресу із затримкою. При індексації мільйонів сторінок навіть затримка у кілька мілісекундів накопичується. Google створив свій DNS, щоб обійти це вузьке місце.
Що насправді бачать павуки?
Коли павук Google заходить на HTML-сторінку, він не читає сторінку так, як це робить людина. Він аналізує структуру. Він зазначає дві критично важливі речі.
- Слова на сторінці.
- Де ці слова.
Розташування визначає вагу. Слова в заголовку, підзаголовку і мета-тегах особливо враховуються при пошукових запитах. Павук також видаляє “стоп-слова”, такі як “a”, “an” та “the”. Хоча часто зустрічаються, вони рідко корисні для розрізнення одного документа від іншого.
Не всі павуки дотримуються цих правил.
Деякі системи, такі як Lycos, намагаються оптимізувати швидкість та ефективність, фокусуючись лише на найважливішому тексті. Вони відстежують заголовки, підзаголовки, посилання та слова у перших 20 рядках контенту. Ми також приділяємо особливу увагу слову, що найчастіше використовується на 100-й сторінці. Це евристичний підхід. Він припускає, що початок і структура є найважливішими.
AltaVista пішла протилежним шляхом. Вона індексує кожне слово. Включаючи «a», «an» та «the». Логіка тут – досконалість. Коли користувач шукає фразу, що містить стоп слово, AltaVista може її виявити. Цей підхід потребує більше місця для зберігання та обчислювальної потужності, але його мета – повнота, а не швидкість.
Чому результати пошуку різні?
Ця різниця у стратегіях пояснює, чому різні пошукові системи повертають різні результати для одного й того самого запиту. Справа не тільки в тому, хто має найбільший індекс. Найважливіше те, що ви вирішуєте індексувати і як ви оцінюєте релевантність.
Деякі павуки віддають перевагу видимому тексту. Інші досліджують невидимі метадані. Деякі ігнорують стоп-слова, щоб заощадити місце. Інші зберігають їх, щоб фіксувати точні збіги фраз.
Битва між швидкістю та цілісністю даних далека від завершення. Вона просто еволюціонувала. Сучасні пошукові системи використовують гібридний підхід, використовуючи машинне навчання для припущення про те, які слова важливі ще до того, як ви натиснете Enter. Однак основний механізм залишається тим самим. Павук падає (переходить). Слід за посиланням. Створює перелік. Ви отримуєте відповідь.
В даний час мережа все ще надто велика, щоб бути повністю охопленою. Павук все ще працює. Вони продовжують знаходити нові сторінки швидше, ніж ми можемо створити їх.