motor de búsqueda. Úselos para buscar recetas, depurar su código o descubrir por qué su Wi-Fi es lento. Pero cuando escribes una consulta en Google, Bing o cualquier otro motor importante, no estás simplemente buscando “en Internet”. Estás buscando en la World Wide Web. Esta distinción es importante porque Internet es una infraestructura. La web es la capa de contenido que se encuentra encima de ella.
Antes de que la Web tomara el poder en los años 90, encontrar información en línea era una molestia. Programas como Gopher y Archie indexan archivos en el servidor. Reducen el tiempo de búsqueda, claro. Pero tenías que saber lo que buscabas y cómo navegar por las primeras y torpes interfaces. A finales de la década de 1980, si querías obtener valor real en línea, tenías que dominar a Gopher, Archie o Veronica. La mayoría de la gente no lo hace. Sólo quieren hacer clic y ver los resultados.
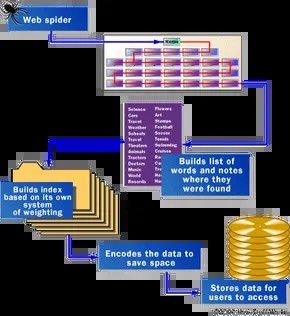
Hoy en día, la atención se centra casi exclusivamente en las páginas web. Para que esto suceda, los motores de búsqueda utilizan robots de software especializados. Las llamamos arañas.
Cómo funciona la indexación web
Cuando las arañas buscan en la web y crean una lista de palabras, este proceso se denomina técnicamente rastreo web. Este nombre se basa en gran medida en metáforas centradas en las arañas, ya que las convenciones de nomenclatura en la industria tecnológica favorecen la novedad sobre la claridad.
La escala es difícil de entender. Hay cientos de millones de páginas. Las arañas no pueden leer todo a la vez. Tiene que empezar por algún lado.
Por lo general, comienza con los pesos pesados. Una lista de servidores y páginas populares con mucho tráfico puede servir como punto de partida. La araña aterriza en el sitio principal, indexa las palabras y sigue todos los enlaces que encuentra. A partir de ahí se extiende. Se mueve lateralmente a través de las partes más conectadas y más utilizadas de la red. Es un efecto dominó. Una página popular apunta a otra página y otra página apunta a otra página. Las arañas no necesitan mapas. Construye su propio camino siguiendo hipervínculos.
El primer motor de Google: la velocidad como característica
Para comprender a los rastreadores modernos, debemos comprender cómo comenzaron los gigantes. Google comenzó como un proyecto académico. Sergey Brin y Larry Page no querían sólo un motor de búsqueda. querían uno rápido.
En su artículo fundamental, presentaron un sistema inicial diseñado para pura velocidad. No ejecutaron ni una sola araña. Ejecutaron varios. Generalmente tres. Cada araña puede mantener alrededor de 300 conexiones abiertas a páginas web al mismo tiempo.
Cuando estas cuatro arañas alcanzaron su punto máximo, el sistema rastreaba más de 100 páginas por segundo. No es sólo rápido. Eso es agresivo. Produce alrededor de 600 KB de datos por segundo.
La velocidad no es gratis. Se necesita infraestructura. La configuración inicial de Google tenía un servidor específico para enviar URL a las arañas. ¿Por qué? Esto se debe a que el servidor de nombres DNS de un ISP estándar traduce un nombre en una dirección IP con retraso. Al indexar millones de páginas, se acumula un retraso de incluso unos pocos milisegundos. Google creó su propio DNS para evitar ese cuello de botella.
¿Qué ven realmente las arañas?
Cuando la araña de Google llega a una página HTML, no “lee” la página como lo hace un humano. Analiza la estructura. Señala dos cosas críticas.
- Palabras en una página.
- Dónde se ubican esas palabras.
La ubicación dicta el peso. Las palabras del título, subtítulo y metaetiquetas se tienen especialmente en cuenta en las búsquedas de los usuarios. La araña también elimina “palabras vacías” como “a”, “an” y “the”. Aunque son comunes, rara vez son útiles para distinguir un documento de otro.
No todas las arañas siguen estas reglas.
Algunos sistemas, como Lycos, intentan optimizar la velocidad y la eficiencia centrándose únicamente en el texto más importante. Realice un seguimiento de títulos, subtítulos, enlaces y palabras en las primeras 20 líneas de contenido. También prestamos especial atención a la palabra más utilizada en la página 100. Es un enfoque heurístico. Se supone que el comienzo y la estructura son lo más importante.
AltaVista tomó el camino opuesto. Indexa cada palabra. Contiene “a”, “una” y “el”. La lógica aquí es la perfección. Cuando un usuario busca una frase que contiene una palabra vacía, AltaVista puede detectarla. Este enfoque requiere más capacidad de almacenamiento y procesamiento, pero el objetivo es la integridad, no la velocidad.
¿Por qué los resultados de la búsqueda son diferentes?
Esta diferencia de estrategia explica por qué diferentes motores de búsqueda arrojan resultados diferentes para la misma consulta. No se trata sólo de quién tiene el índice más grande. Lo que importa es lo que usted decide indexar y cómo evalúa la relevancia.
Algunas arañas prefieren el texto visible. Otros exploran metadatos invisibles. Algunos ignoran las palabras finales para ahorrar espacio. Algunos los conservan para registrar coincidencias exactas de frases.
La batalla entre velocidad e integridad está lejos de terminar. Simplemente evolucionó. Los motores modernos utilizan un enfoque híbrido, utilizando el aprendizaje automático para adivinar qué palabras son importantes antes de presionar Intro. Sin embargo, el mecanismo central sigue siendo el mismo. La araña cayó. Sigue el enlace. Crea una lista. Obtendrás una respuesta.
Actualmente, la red es todavía demasiado grande para poder cartografiarla por completo. La araña sigue corriendo. Siguen encontrando nuevas páginas más rápido de lo que nosotros podemos crearlas.