moteur de recherche. Utilisez-les pour trouver des recettes, déboguer votre code ou découvrir pourquoi votre Wi-Fi est lent. Mais lorsque vous tapez une requête dans Google, Bing ou tout autre moteur majeur, vous ne effectuez pas seulement une recherche « sur Internet ». Vous effectuez une recherche sur le World Wide Web. Cette distinction est importante car Internet est une infrastructure. Le Web est la couche de contenu située au-dessus.
Avant que le Web ne prenne le dessus dans les années 90, trouver des informations en ligne était pénible. Des programmes tels que Gopher et Archie indexent les fichiers sur le serveur. Ils ont réduit le temps de recherche, bien sûr. Mais il fallait savoir ce que l’on cherchait et comment naviguer dans les premières interfaces maladroites. À la fin des années 1980, si vous vouliez obtenir une réelle valeur ajoutée en ligne, vous deviez maîtriser Gopher, Archie ou Veronica. La plupart des gens ne le font pas. Ils veulent juste cliquer et voir les résultats.
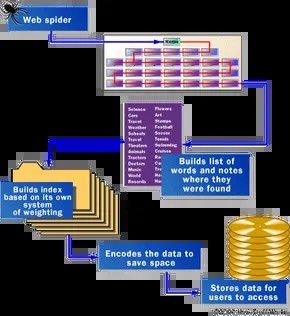
Aujourd’hui, l’accent est presque exclusivement mis sur les pages Web. Pour y parvenir, les moteurs de recherche utilisent des robots logiciels spécialisés. Nous les appelons araignées.
Comment fonctionne l’indexation Web
Lorsque les araignées effectuent des recherches sur le Web et créent une liste de mots, ce processus est techniquement appelé exploration du Web. Ce nom s’appuie fortement sur des métaphores centrées sur l’araignée, car les conventions de dénomination dans l’industrie technologique privilégient la nouveauté plutôt que la clarté.
L’échelle est difficile à comprendre. Il y a des centaines de millions de pages. Les araignées ne peuvent pas tout lire en même temps. Il faut bien que cela commence quelque part.
Habituellement, cela commence par les gros frappeurs. Une liste de serveurs populaires et de pages avec beaucoup de trafic peut servir de point de départ. L’araignée se pose sur le site principal, indexe les mots et suit tous les liens qu’elle trouve. A partir de là, ça s’étend. Il se déplace latéralement à travers les parties du réseau les plus connectées et les plus utilisées. C’est un effet d’entraînement. Une page populaire pointe vers une autre page et une autre page pointe vers une autre page. Les araignées n’ont pas besoin de cartes. Il construit son propre chemin en suivant des hyperliens.
Le premier moteur de Google : la vitesse comme fonctionnalité
Pour comprendre les robots d’exploration modernes, nous devons comprendre comment les géants ont fait leurs débuts. Google a commencé comme un projet académique. Sergey Brin et Larry Page ne voulaient pas seulement un moteur de recherche. ils en voulaient un rapide.
Dans leur article fondateur, ils ont présenté un premier système conçu pour la vitesse pure. Ils n’ont pas couru une seule araignée. Ils en ont couru plusieurs. Généralement trois. Chaque araignée peut maintenir environ 300 connexions ouvertes vers des pages Web en même temps.
Lorsque ces quatre araignées ont atteint leur apogée, le système parcourait plus de 100 pages par seconde. Ce n’est pas seulement rapide. C’est agressif. Il produit environ 600 Ko de données par seconde.
La vitesse n’est pas gratuite. Des infrastructures sont nécessaires. La première configuration de Google disposait d’un serveur spécifique pour fournir des URL aux robots. Pourquoi? En effet, le serveur de noms DNS d’un FAI standard traduit un nom en adresse IP avec un certain délai. Lors de l’indexation de millions de pages, un retard de quelques millisecondes s’accumule. Google a construit son propre DNS pour contourner ce goulot d’étranglement.
Que voient réellement les araignées ?
Lorsque l’araignée de Google atterrit sur une page HTML, elle ne « lit » pas la page comme le fait un humain. Il analyse la structure. Il note deux choses essentielles.
- Mots sur une page.
- Où se trouvent ces mots.
L’emplacement dicte le poids. Les mots présents dans le titre, le sous-titre et les balises méta sont particulièrement pris en compte dans les recherches des utilisateurs. L’araignée supprime également les « mots vides » tels que « un », « un » et « le ». Bien que courants, ces éléments sont rarement utiles pour distinguer un document d’un autre.
Toutes les araignées ne suivent pas ces règles.
Certains systèmes, comme Lycos, tentent d’optimiser la vitesse et l’efficacité en se concentrant uniquement sur le texte le plus important. Suivez les titres, sous-titres, liens et mots dans les 20 premières lignes de contenu. Nous accordons également une attention particulière au mot le plus fréquemment utilisé à la page 100. Il s’agit d’une approche heuristique. Cela suppose que le début et la structure sont les plus importants.
AltaVista a pris le chemin inverse. Il indexe chaque mot. Contient « un », « un » et « le ». La logique ici est la perfection. Lorsqu’un utilisateur recherche une expression contenant un mot vide, AltaVista peut le détecter. Cette approche nécessite davantage de stockage et de puissance de traitement, mais l’objectif est l’exhaustivité et non la vitesse.
Pourquoi les résultats de recherche sont-ils différents ?
Cette différence de stratégie explique pourquoi différents moteurs de recherche renvoient des résultats différents pour la même requête. Il ne s’agit pas seulement de savoir qui a l’indice le plus élevé. Ce qui compte, c’est ce que vous décidez d’indexer et la manière dont vous évaluez la pertinence.
Certaines araignées préfèrent le texte visible. D’autres explorent les métadonnées invisibles. Certains ignorent les mots de clôture pour gagner de la place. Certains les conservent pour enregistrer des correspondances exactes d’expressions.
La bataille entre rapidité et intégrité est loin d’être terminée. Cela a juste évolué. Les moteurs modernes utilisent une approche hybride, utilisant l’apprentissage automatique pour deviner quels mots sont importants avant d’appuyer sur Entrée. Cependant, le mécanisme de base reste le même. L’araignée est tombée. Suivez le lien. Créez une liste. Vous obtiendrez une réponse.
Actuellement, le réseau est encore trop vaste pour être entièrement cartographié. L’araignée court toujours. Ils continuent de trouver de nouvelles pages plus rapidement que nous ne pouvons les créer.