Поисковая система. Используйте их, чтобы находить рецепты, отлаживать код или выяснять, почему Wi-Fi работает медленно. Но когда вы вводите запрос в Google, Bing или любой другой крупный поисковый движок, вы ищете не «Интернет». Вы ищете Всемирную паутину (World Wide Web). Это различие важно, потому что Интернет — это инфраструктура. Веб — это слой контента, расположенный над ней.
До того, как Веб захватил доминирование в 90-х годах, поиск информации в сети был мучительным. Такие программы, как Gopher и Archie, индексировали файлы на серверах. Они, безусловно, сокращали время поиска. Но вам нужно было точно знать, что вы ищете, и уметь ориентироваться в ранних, громоздких интерфейсах. В конце 1980-х годов, если вы хотели получить реальную пользу от онлайн-поиска, вам приходилось осваивать Gopher, Archie или Veronica. Большинство людей этого не делали. Они просто хотели нажать и увидеть результаты.
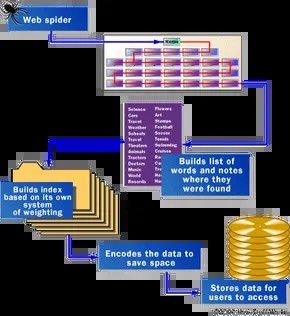
Сегодня фокус почти исключительно смещен на веб-страницы. Чтобы это произошло, поисковые системы используют специализированное программное обеспечение-роботов. Мы называем их пауками (spiders).
Как работает индексация веб-страниц
Когда пауки обходят веб и создают список слов, этот процесс технически называется веб-краулингом (web crawling). Это название сильно опирается на метафоры, связанные с пауками, поскольку соглашения об именах в технологической отрасли отдают предпочтение новизне, а не ясности.
Масштабы трудно осознать. Существуют сотни миллионов страниц. Пауки не могут прочитать всё сразу. Им нужно откуда-то начать.
Обычно это начинается с самых популярных ресурсов. Список популярных серверов и страниц с большим трафиком может служить отправной точкой. Паук заходит на главный сайт, индексирует слова и следует по всем найденным ссылкам. Оттуда он распространяется дальше. Он перемещается по горизонтали через наиболее связанные и наиболее используемые части сети. Это эффект ряби. Одна популярная страница ссылается на другую страницу, а та — на следующую. Паукам не нужны карты. Они строят свой собственный путь, следуя гиперссылкам.
Ранний движок Google: скорость как ключевая особенность
Чтобы понять современных краулеров, нам нужно понять, как гиганты начинали свой путь. Google начинался как академический проект. Сергей Брин и Ларри Пейдж хотели не просто поисковую систему. Они хотели быструю систему.
В своей основополагающей статье они представили раннюю систему, разработанную для чистой скорости. Они запускали не одного паука. Они запускали несколько. Обычно три. Каждый паук может одновременно поддерживать около 300 открытых подключений к веб-страницам.
Когда эти четыре паука достигли пиковой нагрузки, система обходила более 100 страниц в секунду. Это не просто быстро. Это агрессивно. Она генерирует около 600 КБ данных в секунду.
Скорость не даётся даром. Необходима инфраструктура. Ранняя настройка Google имела специальный сервер для подачи URL-адресов паукам. Почему? Потому что DNS-сервер стандартного интернет-провайдера преобразует имя в IP-адрес с задержкой. При индексации миллионов страниц даже задержка в несколько миллисекунд накапливается. Google создал свой собственный DNS, чтобы обойти это узкое место.
Что на самом деле видят пауки?
Когда паук Google заходит на HTML-страницу, он не «читает» страницу так, как это делает человек. Он анализирует структуру. Он отмечает две критически важные вещи.
- Слова на странице.
- Где находятся эти слова.
Расположение определяет вес. Слова в заголовке, подзаголовке и мета-тегах особенно учитываются при пользовательских поисковых запросах. Паук также удаляет «стоп-слова», такие как «a», «an» и «the». Хотя они часто встречаются, они редко полезны для различения одного документа от другого.
Не все пауки следуют этим правилам.
Некоторые системы, такие как Lycos, пытаются оптимизировать скорость и эффективность, фокусируясь только на самом важном тексте. Они отслеживают заголовки, подзаголовки, ссылки и слова в первых 20 строках контента. Мы также уделяем особое внимание самому часто используемому слову на 100-й странице. Это эвристический подход. Он предполагает, что начало и структура являются наиболее важными.
AltaVista пошла по противоположному пути. Она индексирует каждое слово. Включая «a», «an» и «the». Логика здесь — совершенство. Когда пользователь ищет фразу, содержащую стоп-слово, AltaVista может её обнаружить. Этот подход требует больше места для хранения и вычислительной мощности, но его цель — полнота, а не скорость.
Почему результаты поиска разные?
Это различие в стратегиях объясняет, почему разные поисковые системы возвращают разные результаты для одного и того же запроса. Дело не только в том, у кого самый большой индекс. Важнее то, что вы решаете индексировать и как вы оцениваете релевантность.
Некоторые пауки предпочитают видимый текст. Другие исследуют невидимые метаданные. Некоторые игнорируют стоп-слова, чтобы сэкономить место. Другие сохраняют их, чтобы фиксировать точные совпадения фраз.
Битва между скоростью и целостностью данных далека от завершения. Она просто эволюционировала. Современные поисковые системы используют гибридный подход, используя машинное обучение для предположения о том, какие слова важны, ещё до того, как вы нажмете Enter. Однако основной механизм остается прежним. Паук падает (переходит). Следует по ссылке. Создает список. Вы получаете ответ.
В настоящее время сеть всё ещё слишком велика, чтобы быть полностью охваченной. Паук всё ещё работает. Они продолжают находить новые страницы быстрее, чем мы можем их создать.