


Vyhledávač. Použijte je k nalezení receptů, ladění kódu nebo zjištění, proč je Wi-Fi pomalá. Když ale zadáte dotaz do Googlu, Bingu nebo jiného velkého vyhledávače, nehledáte „internet“. Hledáte World Wide Web. Toto rozlišení je důležité, protože internet je infrastruktura. Web je obsahová vrstva nad ním.
Než se v 90. letech ujal web, bylo hledání informací online utrpením. Programy jako Gopher a Archie indexovaly soubory na serverech. Určitě zkrátili dobu hledání. Ale museli jste přesně vědět, co hledáte, a umět se orientovat v raných, neohrabaných rozhraních. Na konci osmdesátých let, pokud jste chtěli získat skutečnou hodnotu z online vyhledávání, museli jste ovládat Gopher, Archie nebo Veronica. Většina lidí to neudělala. Chtěli jen kliknout a vidět výsledky.
Dnes je středem zájmu téměř výhradně web. Aby se to stalo, vyhledávače používají specializovaný robotický software. Říkáme jim pavouci.
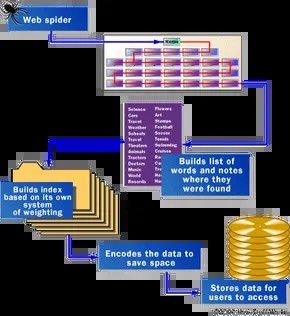
Jak funguje indexování webových stránek
Když pavouci procházejí web a vytvářejí seznam slov, tento proces se odborně nazývá procházení webu. Název se silně opírá o pavoučí metafory, protože konvence pojmenování technického průmyslu upřednostňují novost před jasností.
Stupnice je těžko pochopitelná. Jsou to stovky milionů stránek. Pavouci nedokážou přečíst všechno najednou. Musí někde začít.
Obvykle to začíná nejoblíbenějšími zdroji. Jako výchozí bod může sloužit seznam oblíbených serverů a stránek s vysokou návštěvností. Pavouk přejde na hlavní web, indexuje slova a sleduje všechny odkazy, které najde. Odtud se šíří dále. Pohybuje se horizontálně nejpropojenějšími a nejpoužívanějšími částmi sítě. Toto je vlnový efekt. Jedna oblíbená stránka odkazuje na jinou stránku, která odkazuje na další. Pavouci nepotřebují karty. Vybudují si vlastní cestu sledováním hypertextových odkazů.
Raný Google Engine: Rychlost jako klíčová funkce
Abychom porozuměli moderním crawlerům, musíme pochopit, jak obři začali. Google začal jako akademický projekt. Sergey Brin a Larry Page chtěli víc než jen vyhledávač. Chtěli rychlý systém.
Ve své základní práci představili raný systém navržený pro čistou rychlost. Vypustili více než jednoho pavouka. Spustili několik. Obvykle tři. Každý pavouk může současně udržovat asi 300 otevřených připojení k webovým stránkám.
Když tito čtyři pavouci dosáhli maximálního zatížení, systém procházel více než 100 stránek za sekundu. Není to jen rychlé. Je to agresivní. Generuje asi 600 kB dat za sekundu.
Rychlost není zadarmo. Potřebná infrastruktura. Rané nastavení Google mělo vyhrazený server pro poskytování adres URL pavoukům. Proč? Protože server DNS standardního ISP překládá název na IP adresu se zpožděním. Při indexování milionů stránek se sčítá i několik milisekund latence. Google vytvořil vlastní DNS, aby se tomuto úzkému hrdlu vyhnul.
Co pavouci skutečně vidí?
Když pavouk Google navštíví stránku HTML, „nečte“ stránku jako člověk. Analyzuje strukturu. Poznamenává dvě zásadní věci.
- Slova na stránce.
- Kde se tato slova nacházejí.
Umístění určuje váhu. Slova v názvu, titulcích a metaznačkách jsou zvláště důležitá pro vyhledávací dotazy uživatelů. Pavouk také odstraňuje “stop slova” jako “a”, “an” a “the”. I když jsou běžné, jen zřídka jsou užitečné pro rozlišení jednoho dokumentu od druhého.
Ne všichni pavouci tato pravidla dodržují.
Některé systémy, jako je Lycos, se snaží optimalizovat rychlost a efektivitu tím, že se zaměřují pouze na nejdůležitější text. Sledují nadpisy, podnadpisy, odkazy a slova v prvních 20 řádcích obsahu. Zvláštní pozornost věnujeme také nejčastěji používanému slovu na straně 100. Jedná se o heuristický přístup. Naznačuje, že začátek a struktura jsou nejdůležitější.
AltaVista šla opačnou cestou. Indexuje každé slovo. Včetně “a”, “an” a “the”. Logika je zde dokonalá. Když uživatel hledá frázi, která obsahuje zastavovací slovo, AltaVista ji dokáže detekovat. Tento přístup vyžaduje více úložného prostoru a výpočetního výkonu, ale jeho cílem je úplnost, nikoli rychlost.
Proč se výsledky vyhledávání liší?
Tento rozdíl ve strategii vysvětluje, proč různé vyhledávače vracejí různé výsledky pro stejný dotaz. Nejde jen o to, kdo má největší index. Důležitější je, co se rozhodnete indexovat a jak posoudíte relevanci.
Někteří pavouci preferují viditelný text. Jiní zkoumají neviditelná metadata. Někteří lidé ignorují bezpečná slova, aby ušetřili místo. Jiní je ukládají, aby zaznamenali přesné frázové shody.
Bitva mezi rychlostí a integritou dat zdaleka nekončí. Prostě se vyvinula. Moderní vyhledávače používají hybridní přístup a pomocí strojového učení odhadují, která slova jsou důležitá, ještě předtím, než stisknete Enter. Základní mechanismus však zůstává stejný. Pavouk padá (kříží). Postupujte podle odkazu. Vytvoří seznam. Dostanete odpověď.
V současné době je síť stále příliš velká na to, aby byla plně pokryta. Pavouk stále funguje. Stále nacházejí nové stránky rychleji, než je dokážeme vytvořit.


