Suchmaschine. Verwenden Sie diese, um Rezepte zu finden, Ihren Code zu debuggen oder herauszufinden, warum Ihr WLAN langsam ist. Aber wenn Sie eine Suchanfrage in Google, Bing oder eine andere große Suchmaschine eingeben, durchsuchen Sie nicht nur „das Internet“. Sie durchsuchen das World Wide Web. Diese Unterscheidung ist wichtig, da das Internet eine Infrastruktur ist. Das Web ist die darüber liegende Inhaltsschicht.
Bevor das Internet in den 90er-Jahren die Oberhand gewann, war die Suche nach Informationen im Internet mühsam. Programme wie Gopher und Archie indizieren Dateien auf dem Server. Sie verkürzen auf jeden Fall die Suchzeit. Aber man musste wissen, wonach man suchte und wie man sich in den frühen, klobigen Benutzeroberflächen zurechtfindet. Wenn man in den späten 1980er Jahren online einen echten Mehrwert erzielen wollte, musste man Gopher, Archie oder Veronica beherrschen. Die meisten Leute tun das nicht. Sie wollen einfach nur klicken und die Ergebnisse sehen.
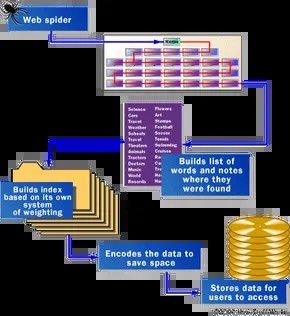
Heutzutage liegt der Fokus fast ausschließlich auf Webseiten. Um dies zu erreichen, nutzen Suchmaschinen spezielle Software-Roboter. Wir nennen sie Spinnen.
So funktioniert die Webindizierung
Wenn Spinnen das Web durchsuchen und eine Liste mit Wörtern erstellen, wird dieser Vorgang technisch als Web-Crawling bezeichnet. Dieser Name lehnt sich stark an spinnenzentrierte Metaphern an, da Namenskonventionen in der Technologiebranche Neuheit gegenüber Klarheit bevorzugen.
Die Waage ist schwer zu verstehen. Es gibt Hunderte Millionen Seiten. Spinnen können nicht alles auf einmal lesen. Es muss irgendwo beginnen.
Normalerweise beginnt es mit den Heavy Hittern. Als Ausgangspunkt kann eine Liste beliebter Server und Seiten mit viel Traffic dienen. Die Spinne landet auf der Hauptseite, indiziert die Wörter und folgt allen gefundenen Links. Von dort aus breitet es sich aus. Es bewegt sich seitlich über die am stärksten verbundenen und am häufigsten genutzten Teile des Netzwerks. Es ist ein Welleneffekt. Eine beliebte Seite verweist auf eine andere Seite und eine andere Seite verweist auf eine andere Seite. Spinnen brauchen keine Karten. Es baut seinen eigenen Pfad auf, indem es Hyperlinks folgt.
Googles frühe Engine: Geschwindigkeit als Feature
Um moderne Crawler zu verstehen, müssen wir verstehen, wie die Giganten ihren Anfang nahmen. Google begann als akademisches Projekt. Sergey Brin und Larry Page wollten nicht nur eine Suchmaschine. Sie wollten ein schnelles.
In ihrer bahnbrechenden Arbeit stellten sie ein frühes System vor, das auf pure Geschwindigkeit ausgelegt war. Sie ließen keine einzige Spinne laufen. Sie liefen mehrfach. Normalerweise drei. Jeder Spider kann gleichzeitig etwa 300 offene Verbindungen zu Webseiten aufrechterhalten.
Als diese vier Spinnen ihren Höhepunkt erreichten, durchsuchte das System über 100 Seiten pro Sekunde. Es ist nicht nur schnell. Das ist aggressiv. Es produziert etwa 600 KB Daten pro Sekunde.
Geschwindigkeit ist nicht umsonst. Infrastruktur ist nötig. Die frühe Einrichtung von Google verfügte über einen speziellen Server, um URLs an die Spider weiterzuleiten. Warum? Dies liegt daran, dass der DNS-Nameserver eines Standard-ISP einen Namen mit Verzögerung in eine IP-Adresse übersetzt. Bei der Indizierung von Millionen von Seiten kommt es zu einer Verzögerung von einigen Millisekunden. Google hat sein eigenes DNS entwickelt, um diesen Engpass zu umgehen.
Was sehen Spinnen wirklich?
Wenn der Google-Spider auf einer HTML-Seite landet, „liest“ er die Seite nicht wie ein Mensch. Es analysiert die Struktur. Es werden zwei wichtige Dinge festgestellt.
- Wörter auf einer Seite.
- Wo sich diese Wörter befinden.
Der Standort bestimmt das Gewicht. Bei der Benutzersuche werden insbesondere die Wörter im Titel, im Untertitel und in den Meta-Tags berücksichtigt. Der Spider entfernt auch „Stoppwörter“ wie „a“, „an“ und „the“. Obwohl sie häufig vorkommen, sind sie selten nützlich, um ein Dokument von einem anderen zu unterscheiden.
Not all spiders follow these rules.
Einige Systeme wie Lycos versuchen, Geschwindigkeit und Effizienz zu optimieren, indem sie sich nur auf den wichtigsten Text konzentrieren. Verfolgen Sie Titel, Untertitel, Links und Wörter in den ersten 20 Zeilen des Inhalts. Besonderes Augenmerk legen wir auch auf das am häufigsten verwendete Wort auf Seite 100. Es handelt sich um einen heuristischen Ansatz. Dabei wird davon ausgegangen, dass Anfang und Struktur am wichtigsten sind.
AltaVista took the opposite route. Es indiziert jedes Wort. Contains “a”, “an” and “the”. The logic here is perfection. Wenn ein Benutzer nach einer Phrase sucht, die ein Stoppwort enthält, erkennt AltaVista dieses möglicherweise. Dieser Ansatz erfordert mehr Speicher- und Rechenleistung, aber das Ziel ist Vollständigkeit und nicht Geschwindigkeit.
Why are the search results different?
Dieser Strategieunterschied erklärt, warum verschiedene Suchmaschinen unterschiedliche Ergebnisse für dieselbe Suchanfrage liefern. It’s not just about who has the biggest index. Entscheidend ist, was Sie indizieren und wie Sie die Relevanz bewerten.
Some spiders prefer visible text. Others explore invisible metadata. Some ignore closing words to save space. Some keep them to record exact phrase matches.
Der Kampf zwischen Geschwindigkeit und Integrität ist noch lange nicht vorbei. Es hat sich einfach weiterentwickelt. Moderne Engines verwenden einen hybriden Ansatz und nutzen maschinelles Lernen, um zu erraten, welche Wörter wichtig sind, bevor Sie die Eingabetaste drücken. However, the core mechanism remains the same. Die Spinne fiel. Folgen Sie dem Link. Erstellen Sie eine Liste. Sie erhalten eine Antwort.
Derzeit ist das Netzwerk noch zu groß, um vollständig abgebildet zu werden. The spider is still running. Sie finden immer schneller neue Seiten, als wir sie erstellen können.