


zoekmachine. Gebruik deze om recepten te vinden, fouten in uw code op te sporen of erachter te komen waarom uw wifi traag is. Maar wanneer u een zoekopdracht in Google, Bing of een andere grote zoekmachine typt, zoekt u niet alleen maar op ‘het internet’. U zoekt op het World Wide Web. Dit onderscheid is belangrijk omdat internet een infrastructuur is. Het web is de inhoudslaag erboven.
Voordat het internet in de jaren negentig de macht overnam, was het vinden van informatie online lastig. Programma’s zoals Gopher en Archie indexbestanden op de server. Ze hebben de zoektijd zeker verkort. Maar je moest weten waar je naar op zoek was en hoe je door de vroege, onhandige interfaces moest navigeren. Als je eind jaren tachtig echte waarde online wilde krijgen, moest je Gopher, Archie of Veronica beheersen. De meeste mensen niet. Ze willen gewoon klikken en de resultaten zien.
Tegenwoordig ligt de focus vrijwel uitsluitend op webpagina’s. Om dat mogelijk te maken, gebruiken zoekmachines gespecialiseerde softwarerobots. We noemen ze spinnen.
Hoe webindexering werkt
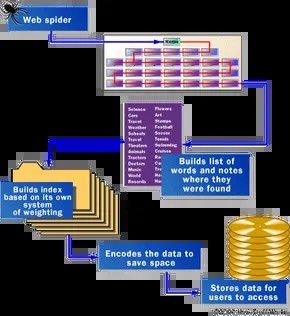
Wanneer spiders op internet zoeken en een lijst met woorden maken, wordt dit proces technisch gezien webcrawlen genoemd. Deze naam leunt zwaar op spin-centrische metaforen, omdat naamgevingsconventies in de technologie-industrie nieuwigheid boven duidelijkheid verkiezen.
De weegschaal is moeilijk om je hoofd omheen te wikkelen. Er zijn honderden miljoenen pagina’s. Spinnen kunnen niet alles in één keer lezen. Het moet ergens beginnen.
Meestal begint het met de zware hitters. Een lijst met populaire servers en pagina’s met veel verkeer kan als uitgangspunt dienen. De spin landt op de hoofdsite, indexeert de woorden en volgt alle links die hij vindt. Van daaruit verspreidt het zich. Het beweegt zich lateraal over de meest verbonden en meest gebruikte delen van het netwerk. Het is een rimpeleffect. De ene populaire pagina verwijst naar een andere pagina en een andere pagina verwijst naar een andere pagina. Spinnen hebben geen kaarten nodig. Het bouwt zijn eigen pad door hyperlinks te volgen.
De vroege engine van Google: snelheid als functie
Om moderne crawlers te begrijpen, moeten we begrijpen hoe de reuzen zijn begonnen. Google begon als een academisch project. Sergey Brin en Larry Page wilden niet alleen een zoekmachine. ze wilden een snelle.
In hun baanbrekende artikel presenteerden ze een vroeg systeem dat was ontworpen voor pure snelheid. Ze hebben niet één spin gerund. Ze liepen er meerdere. Meestal drie. Elke spider kan tegelijkertijd ongeveer 300 open verbindingen met webpagina’s onderhouden.
Toen deze vier spiders hun hoogtepunt bereikten, crawlde het systeem meer dan 100 pagina’s per seconde. Het is niet alleen snel. Dat is agressief. Het produceert ongeveer 600 KB aan gegevens per seconde.
Snelheid is niet gratis. Er is infrastructuur nodig. De vroege installatie van Google had een specifieke server om URL’s naar de spiders te sturen. Waarom? Dit komt doordat de DNS-naamserver van een standaard ISP een naam met vertraging vertaalt naar een IP-adres. Bij het indexeren van miljoenen pagina’s ontstaat er een vertraging van zelfs enkele milliseconden. Google heeft zijn eigen DNS gebouwd om dat knelpunt te omzeilen.
Wat zien spinnen echt?
Wanneer de Google-spider op een HTML-pagina terechtkomt, “leest” hij de pagina niet zoals een mens dat doet. Het ontleedt structuur. Er worden twee cruciale zaken opgemerkt.
- Woorden op een pagina.
- Waar deze woorden zich bevinden.
Locatie dicteert gewicht. Bij zoekopdrachten van gebruikers wordt vooral rekening gehouden met de woorden in de titel, ondertitel en metatags. De spin verwijdert ook “stopwoorden” zoals “a”, “een” en “de”. Hoewel gebruikelijk, zijn deze zelden nuttig om het ene document van het andere te onderscheiden.
Niet alle spinnen volgen deze regels.
Sommige systemen, zoals Lycos, proberen de snelheid en efficiëntie te optimaliseren door zich alleen op de belangrijkste tekst te concentreren. Volg titels, ondertitels, links en woorden in de eerste 20 regels met inhoud. We besteden ook speciale aandacht aan het meest gebruikte woord op pagina 100. Het is een heuristische benadering. Het gaat ervan uit dat begin en structuur het belangrijkst zijn.
AltaVista volgde de tegenovergestelde route. Het indexeert elk woord. Bevat “een”, “een” en “de”. De logica hier is perfectie. Wanneer een gebruiker zoekt naar een zin die een stopwoord bevat, kan AltaVista deze detecteren. Deze aanpak vereist meer opslag- en verwerkingskracht, maar het doel is volledigheid en niet snelheid.
Waarom zijn de zoekresultaten anders?
Dit verschil in strategie verklaart waarom verschillende zoekmachines verschillende resultaten opleveren voor dezelfde zoekopdracht. Het gaat niet alleen om wie de grootste index heeft. Het gaat erom wat u besluit te indexeren en hoe u de relevantie beoordeelt.
Sommige spinnen geven de voorkeur aan zichtbare tekst. Anderen verkennen onzichtbare metadata. Sommigen negeren slotwoorden om ruimte te besparen. Sommigen bewaren ze om exacte woordgroepovereenkomsten vast te leggen.
De strijd tussen snelheid en integriteit is nog lang niet voorbij. Het is gewoon geëvolueerd. Moderne zoekmachines gebruiken een hybride aanpak, waarbij machine learning wordt gebruikt om te raden welke woorden belangrijk zijn voordat je op Enter drukt. Het kernmechanisme blijft echter hetzelfde. De spin viel. Volg de link. Maak een lijst. U krijgt antwoord.
Momenteel is het netwerk nog te groot om volledig in kaart te brengen. De spin loopt nog steeds. Ze vinden steeds sneller nieuwe pagina’s dan wij ze kunnen maken.


