


mecanismo de busca. Use-os para encontrar receitas, depurar seu código ou descobrir por que seu Wi-Fi está lento. Mas quando você digita uma consulta no Google, Bing ou qualquer outro mecanismo importante, você não está apenas pesquisando “na Internet”. Você está pesquisando na World Wide Web. Esta distinção é importante porque a Internet é uma infra-estrutura. A web é a camada de conteúdo acima dela.
Antes da Web assumir o controle, nos anos 90, encontrar informações on-line era uma tarefa difícil. Programas como Gopher e Archie indexam arquivos no servidor. Eles reduziram o tempo de pesquisa, com certeza. Mas você tinha que saber o que estava procurando e como navegar nas interfaces antigas e desajeitadas. No final da década de 1980, se você quisesse obter valor real online, teria que dominar Gopher, Archie ou Veronica. A maioria das pessoas não. Eles só querem clicar e ver os resultados.
Hoje, o foco está quase exclusivamente nas páginas da Web. Para que isso aconteça, os motores de busca utilizam robôs de software especializados. Nós as chamamos de aranhas.
Como funciona a indexação da Web
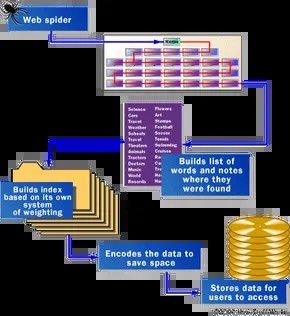
Quando os spiders pesquisam na web e criam uma lista de palavras, esse processo é tecnicamente chamado de rastreamento da web. Este nome depende fortemente de metáforas centradas em aranhas, já que as convenções de nomenclatura na indústria de tecnologia favorecem a novidade em vez da clareza.
A escala é difícil de entender. Existem centenas de milhões de páginas. As aranhas não conseguem ler tudo de uma vez. Tem que começar em algum lugar.
Geralmente, tudo começa com os pesos pesados. Uma lista de servidores populares e páginas com muito tráfego pode servir como ponto de partida. A aranha chega ao site principal, indexa as palavras e segue todos os links que encontra. A partir daí, ele se espalha. Ele se move lateralmente pelas partes mais conectadas e utilizadas da rede. É um efeito cascata. Uma página popular aponta para outra página e outra página aponta para outra página. As aranhas não precisam de mapas. Ele constrói seu próprio caminho seguindo hiperlinks.
O mecanismo inicial do Google: velocidade como recurso
Para entender os crawlers modernos, precisamos entender como os gigantes começaram. O Google começou como um projeto acadêmico. Sergey Brin e Larry Page não queriam apenas um mecanismo de busca. eles queriam um rápido.
Em seu artigo seminal, eles apresentaram um sistema inicial projetado para pura velocidade. Eles não correram uma aranha. Eles correram vários. Geralmente três. Cada spider pode manter cerca de 300 conexões abertas com páginas da web ao mesmo tempo.
Quando esses quatro spiders atingiram seu pico, o sistema rastreava mais de 100 páginas por segundo. Não é apenas rápido. Isso é agressivo. Produz cerca de 600 KB de dados por segundo.
A velocidade não é gratuita. É necessária infraestrutura. A configuração inicial do Google tinha um servidor específico para fornecer URLs aos spiders. Por que? Isso ocorre porque o servidor de nomes DNS de um ISP padrão traduz um nome em um endereço IP com atraso. Ao indexar milhões de páginas, acumula-se um atraso de alguns milissegundos. O Google construiu seu próprio DNS para contornar esse gargalo.
O que as aranhas realmente veem?
Quando o spider do Google chega a uma página HTML, ele não “lê” a página como um ser humano faz. Ele analisa a estrutura. Ele observa duas coisas críticas.
- Palavras em uma página.
- Onde essas palavras estão localizadas.
A localização determina o peso. As palavras do título, subtítulo e meta tags são especialmente levadas em consideração nas pesquisas dos usuários. O spider também remove “palavras irrelevantes”, como “a”, “an” e “the”. Embora comuns, raramente são úteis para distinguir um documento de outro.
Nem todas as aranhas seguem estas regras.
Alguns sistemas, como o Lycos, tentam otimizar a velocidade e a eficiência concentrando-se apenas no texto mais importante. Acompanhe títulos, legendas, links e palavras nas primeiras 20 linhas de conteúdo. Também prestamos atenção especial à palavra usada com mais frequência na página 100. É uma abordagem heurística. Assume que o início e a estrutura são os mais importantes.
O AltaVista seguiu o caminho oposto. Ele indexa cada palavra. Contém “a”, “an” e “the”. A lógica aqui é a perfeição. Quando um usuário pesquisa uma frase que contém uma palavra irrelevante, o AltaVista pode detectá-la. Essa abordagem requer mais capacidade de armazenamento e processamento, mas o objetivo é a integridade, não a velocidade.
Por que os resultados da pesquisa são diferentes?
Essa diferença de estratégia explica por que diferentes mecanismos de pesquisa retornam resultados diferentes para a mesma consulta. Não se trata apenas de quem tem o maior índice. O que importa é o que você decide indexar e como avalia a relevância.
Algumas aranhas preferem texto visível. Outros exploram metadados invisíveis. Alguns ignoram as palavras finais para economizar espaço. Alguns os mantêm para registrar correspondências exatas de frases.
A batalha entre velocidade e integridade está longe de terminar. Simplesmente evoluiu. Os mecanismos modernos usam uma abordagem híbrida, usando aprendizado de máquina para adivinhar quais palavras são importantes antes de pressionar Enter. No entanto, o mecanismo central permanece o mesmo. A aranha caiu. Siga o link. Crie uma lista. Você receberá uma resposta.
Atualmente, a rede ainda é muito grande para ser totalmente mapeada. A aranha ainda está correndo. Eles continuam encontrando novas páginas mais rápido do que conseguimos criá-las.


