


mesin pencari. Gunakan ini untuk menemukan resep, men-debug kode Anda, atau mencari tahu mengapa Wi-Fi Anda lambat. Namun saat Anda mengetikkan kueri ke Google, Bing, atau mesin besar lainnya, Anda tidak hanya menelusuri “Internet”. Anda sedang mencari di World Wide Web. Pembedaan ini penting karena Internet merupakan sebuah infrastruktur. Web adalah lapisan konten di atasnya.
Sebelum Web mengambil alih pada tahun 90an, mencari informasi secara online sangatlah sulit. Program seperti Gopher dan Archie mengindeks file di server. Mereka tentu saja mengurangi waktu pencarian. Namun Anda harus tahu apa yang Anda cari dan cara menavigasi antarmuka awal yang kikuk. Pada akhir tahun 1980an, jika Anda ingin mendapatkan nilai nyata secara online, Anda harus menguasai Gopher, Archie, atau Veronica. Kebanyakan orang tidak. Mereka hanya ingin mengklik dan melihat hasilnya.
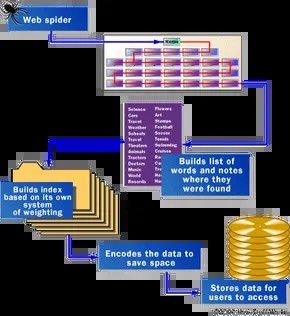
Saat ini, fokusnya hampir secara eksklusif pada halaman Web. Untuk mewujudkannya, mesin pencari menggunakan robot perangkat lunak khusus. Kami menyebutnya laba-laba.
Cara Kerja Pengindeksan Web
Saat laba-laba menelusuri web dan membuat daftar kata, proses ini secara teknis disebut perayapan web. Nama ini sangat bergantung pada metafora yang berpusat pada laba-laba, karena konvensi penamaan di industri teknologi lebih mengutamakan hal baru daripada kejelasan.
Skalanya sulit untuk dipahami. Ada ratusan juta halaman. Laba-laba tidak bisa membaca semuanya sekaligus. Itu harus dimulai dari suatu tempat.
Biasanya, ini dimulai dengan para pemukul berat. Daftar server dan halaman populer dengan banyak lalu lintas dapat berfungsi sebagai titik awal. Laba-laba mendarat di situs utama, mengindeks kata-kata dan mengikuti semua tautan yang ditemukannya. Dari situlah menyebar. Ia bergerak secara lateral melintasi bagian jaringan yang paling terhubung dan paling banyak digunakan. Ini adalah efek riak. Satu halaman populer menunjuk ke halaman lain dan halaman lain menunjuk ke halaman lain. Laba-laba tidak membutuhkan peta. Ia membangun jalurnya sendiri dengan mengikuti hyperlink.
Mesin Awal Google: Kecepatan sebagai Fitur
Untuk memahami crawler modern, kita perlu memahami bagaimana raksasa memulainya. Google dimulai sebagai proyek akademis. Sergey Brin dan Larry Page tidak hanya menginginkan mesin pencari. mereka menginginkan yang cepat.
Dalam makalah penting mereka, mereka mempresentasikan sistem awal yang dirancang untuk kecepatan murni. Mereka tidak menjalankan satu laba-laba pun. Mereka berlari berkali-kali. Biasanya tiga. Setiap laba-laba dapat memelihara sekitar 300 koneksi terbuka ke halaman web pada saat yang bersamaan.
Ketika keempat laba-laba ini mencapai puncaknya, sistem merayapi lebih dari 100 halaman per detik. Ini tidak hanya cepat. Itu agresif. Ini menghasilkan sekitar 600 KB data per detik.
Kecepatan tidak gratis. Dibutuhkan infrastruktur. Pengaturan awal Google memiliki server khusus untuk memberi makan URL ke laba-laba. Mengapa? Ini karena server nama DNS dari ISP standar menerjemahkan nama menjadi alamat IP dengan penundaan. Saat mengindeks jutaan halaman, penundaan bahkan beberapa milidetik terakumulasi. Google membuat DNS sendiri untuk mengatasi hambatan tersebut.
Apa yang sebenarnya dilihat laba-laba?
Saat laba-laba Google mendarat di halaman HTML, ia tidak “membaca” halaman tersebut seperti yang dilakukan manusia. Ini mem-parsing struktur. Ini mencatat dua hal penting.
- Kata-kata di halaman.
- Dimana letak kata-kata tersebut.
Lokasi menentukan berat badan. Kata-kata dalam judul, subjudul, dan meta tag terutama diperhitungkan dalam pencarian pengguna. Laba-laba juga menghilangkan “kata-kata berhenti” seperti “a”, “an” dan “the”. Meskipun umum, hal ini jarang berguna dalam membedakan satu dokumen dengan dokumen lainnya.
Tidak semua laba-laba mengikuti aturan ini.
Beberapa sistem, seperti Lycos, mencoba mengoptimalkan kecepatan dan efisiensi dengan hanya berfokus pada teks yang paling penting. Lacak judul, subjudul, tautan, dan kata-kata di 20 baris pertama konten. Kami juga memberikan perhatian khusus pada kata yang paling sering digunakan di halaman 100. Ini adalah pendekatan heuristik. Diasumsikan bahwa permulaan dan struktur adalah yang paling penting.
AltaVista mengambil rute sebaliknya. Ini mengindeks setiap kata. Berisi “a”, “an” dan “the”. Logikanya di sini adalah kesempurnaan. Saat pengguna mencari frasa yang mengandung kata berhenti, AltaVista dapat mendeteksinya. Pendekatan ini memerlukan lebih banyak penyimpanan dan daya pemrosesan, namun tujuannya adalah kelengkapan, bukan kecepatan.
Mengapa hasil pencariannya berbeda?
Perbedaan strategi ini menjelaskan mengapa mesin pencari yang berbeda memberikan hasil yang berbeda untuk kueri yang sama. Ini bukan hanya soal siapa yang memiliki indeks terbesar. Yang penting adalah apa yang Anda putuskan untuk diindeks dan bagaimana Anda menilai relevansinya.
Beberapa laba-laba lebih menyukai teks yang terlihat. Yang lain mengeksplorasi metadata yang tidak terlihat. Beberapa mengabaikan kata penutup untuk menghemat ruang. Beberapa menyimpannya untuk mencatat pencocokan frasa yang tepat.
Pertarungan antara kecepatan dan integritas masih jauh dari selesai. Itu baru saja berkembang. Mesin modern menggunakan pendekatan hybrid, menggunakan pembelajaran mesin untuk menebak kata mana yang penting sebelum Anda menekan enter. Namun mekanisme intinya tetap sama. Laba-laba itu jatuh. Ikuti tautannya. Buat daftar. Anda akan mendapatkan jawabannya.
Saat ini, jaringan tersebut masih terlalu besar untuk dipetakan sepenuhnya. Laba-laba itu masih berjalan. Mereka terus menemukan halaman baru lebih cepat daripada kemampuan kita membuatnya.


