


motore di ricerca. Usali per trovare ricette, eseguire il debug del codice o scoprire perché il tuo Wi-Fi è lento. Ma quando digiti una query su Google, Bing o qualsiasi altro motore importante, non stai solo cercando “su Internet”. Stai effettuando una ricerca nel World Wide Web. Questa distinzione è importante perché Internet è un’infrastruttura. Il web è lo strato di contenuti sopra di esso.
Prima che il Web prendesse il sopravvento negli anni ’90, trovare informazioni online era una seccatura. Programmi come Gopher e Archie indicizzano i file sul server. Riducono i tempi di ricerca, certo. Ma dovevi sapere cosa stavi cercando e come navigare nelle prime e goffe interfacce. Alla fine degli anni ’80, se volevi ottenere un valore reale online, dovevi padroneggiare Gopher, Archie o Veronica. La maggior parte delle persone no. Vogliono solo fare clic e vedere i risultati.
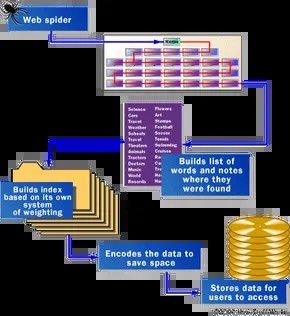
Oggi l’attenzione è quasi esclusivamente sulle pagine Web. Per far sì che ciò accada, i motori di ricerca utilizzano robot software specializzati. Li chiamiamo ragni.
Come funziona l’indicizzazione web
Quando gli spider effettuano una ricerca sul Web e creano un elenco di parole, questo processo è tecnicamente chiamato scansione del Web. Questo nome si basa fortemente su metafore incentrate sul ragno, poiché le convenzioni di denominazione nel settore tecnologico favoriscono la novità rispetto alla chiarezza.
È difficile comprendere la scala. Ci sono centinaia di milioni di pagine. I ragni non possono leggere tutto in una volta. Deve iniziare da qualche parte.
Di solito si comincia con i pezzi forti. Un elenco di server e pagine popolari con molto traffico può servire come punto di partenza. Lo spider atterra sul sito principale, indicizza le parole e segue tutti i link che trova. Da lì si diffonde. Si muove lateralmente attraverso le parti più connesse e più utilizzate della rete. È un effetto a catena. Una pagina popolare punta a un’altra pagina e un’altra pagina punta a un’altra pagina. I ragni non hanno bisogno di mappe. Costruisce il proprio percorso seguendo i collegamenti ipertestuali.
Il primo motore di Google: la velocità come caratteristica
Per comprendere i crawler moderni, dobbiamo capire come hanno avuto inizio i giganti. Google è iniziato come un progetto accademico. Sergey Brin e Larry Page non volevano solo un motore di ricerca. ne volevano uno veloce.
Nel loro articolo fondamentale, hanno presentato un primo sistema progettato per la velocità pura. Non hanno eseguito un ragno. Hanno corso più. Di solito tre. Ogni spider può mantenere circa 300 connessioni aperte a pagine web contemporaneamente.
Quando questi quattro spider raggiungevano il loro picco, il sistema eseguiva la scansione di oltre 100 pagine al secondo. Non è solo veloce. È aggressivo. Produce circa 600 KB di dati al secondo.
La velocità non è gratuita. Sono necessarie infrastrutture. La prima configurazione di Google prevedeva un server specifico per fornire gli URL agli spider. Perché? Questo perché il server dei nomi DNS di un ISP standard traduce un nome in un indirizzo IP con un ritardo. Quando si indicizzano milioni di pagine, si accumula un ritardo anche di pochi millisecondi. Google ha creato il proprio DNS per aggirare questo collo di bottiglia.
Cosa vedono realmente i ragni?
Quando lo spider di Google arriva su una pagina HTML, non “legge” la pagina come fa un essere umano. Analizza la struttura. Rileva due cose critiche.
- Parole su una pagina.
- Dove si trovano quelle parole.
La posizione determina il peso. Nelle ricerche degli utenti vengono prese in considerazione soprattutto le parole del titolo, del sottotitolo e dei meta tag. Lo spider rimuove anche le “parole non significative” come “a”, “an” e “the”. Sebbene comuni, raramente sono utili per distinguere un documento da un altro.
Non tutti i ragni seguono queste regole.
Alcuni sistemi, come Lycos, cercano di ottimizzare la velocità e l’efficienza concentrandosi solo sul testo più importante. Tieni traccia di titoli, sottotitoli, collegamenti e parole nelle prime 20 righe di contenuto. Prestiamo particolare attenzione anche alla parola usata più frequentemente a pagina 100. È un approccio euristico. Si presuppone che l’inizio e la struttura siano più importanti.
AltaVista ha preso la strada opposta. Indicizza ogni parola. Contiene “a”, “an” e “the”. La logica qui è la perfezione. Quando un utente cerca una frase che contiene una parola non significativa, AltaVista potrebbe rilevarla. Questo approccio richiede maggiore potenza di archiviazione e di elaborazione, ma l’obiettivo è la completezza, non la velocità.
Perché i risultati della ricerca sono diversi?
Questa differenza di strategia spiega perché diversi motori di ricerca restituiscono risultati diversi per la stessa query. Non si tratta solo di chi ha l’indice più grande. Ciò che conta è cosa decidi di indicizzare e come valuti la pertinenza.
Alcuni ragni preferiscono il testo visibile. Altri esplorano metadati invisibili. Alcuni ignorano le parole di chiusura per risparmiare spazio. Alcuni li tengono per registrare le corrispondenze esatte delle frasi.
La battaglia tra velocità e integrità è lungi dall’essere finita. Si è semplicemente evoluto. I motori moderni utilizzano un approccio ibrido, utilizzando l’apprendimento automatico per indovinare quali parole sono importanti prima di premere invio. Tuttavia, il meccanismo principale rimane lo stesso. Il ragno cadde. Segui il collegamento. Crea un elenco. Riceverai una risposta.
Attualmente la rete è ancora troppo grande per essere mappata completamente. Il ragno sta ancora correndo. Continuano a trovare nuove pagine più velocemente di quanto riusciamo a crearle.


